 小机器人从一叠示例卡片里发现规律 · 点击放大
 小机器人用注意力聚焦最相关的卡片和连接网络 · 点击放大
 小机器人先去图书馆找到相关资料,再回来回答问题 · 点击放大
 小机器人把小小拼图块组成一句话 · 点击放大
 小机器人在透明安全盒里测试一座小桥 · 点击放大
 小机器人用一把小钥匙保护个人笔记,并留下清晰行动足迹 · 点击放大
 把工具、记忆、检查灯放进有序工作台的智能体 · 点击放大
 小机器人保存记忆、遇到重要动作先等人确认 · 点击放大
 小机器人用示例反复练习,并听取人的反馈 · 点击放大
 小机器人在想象云朵与可靠资料之间核对答案 · 点击放大
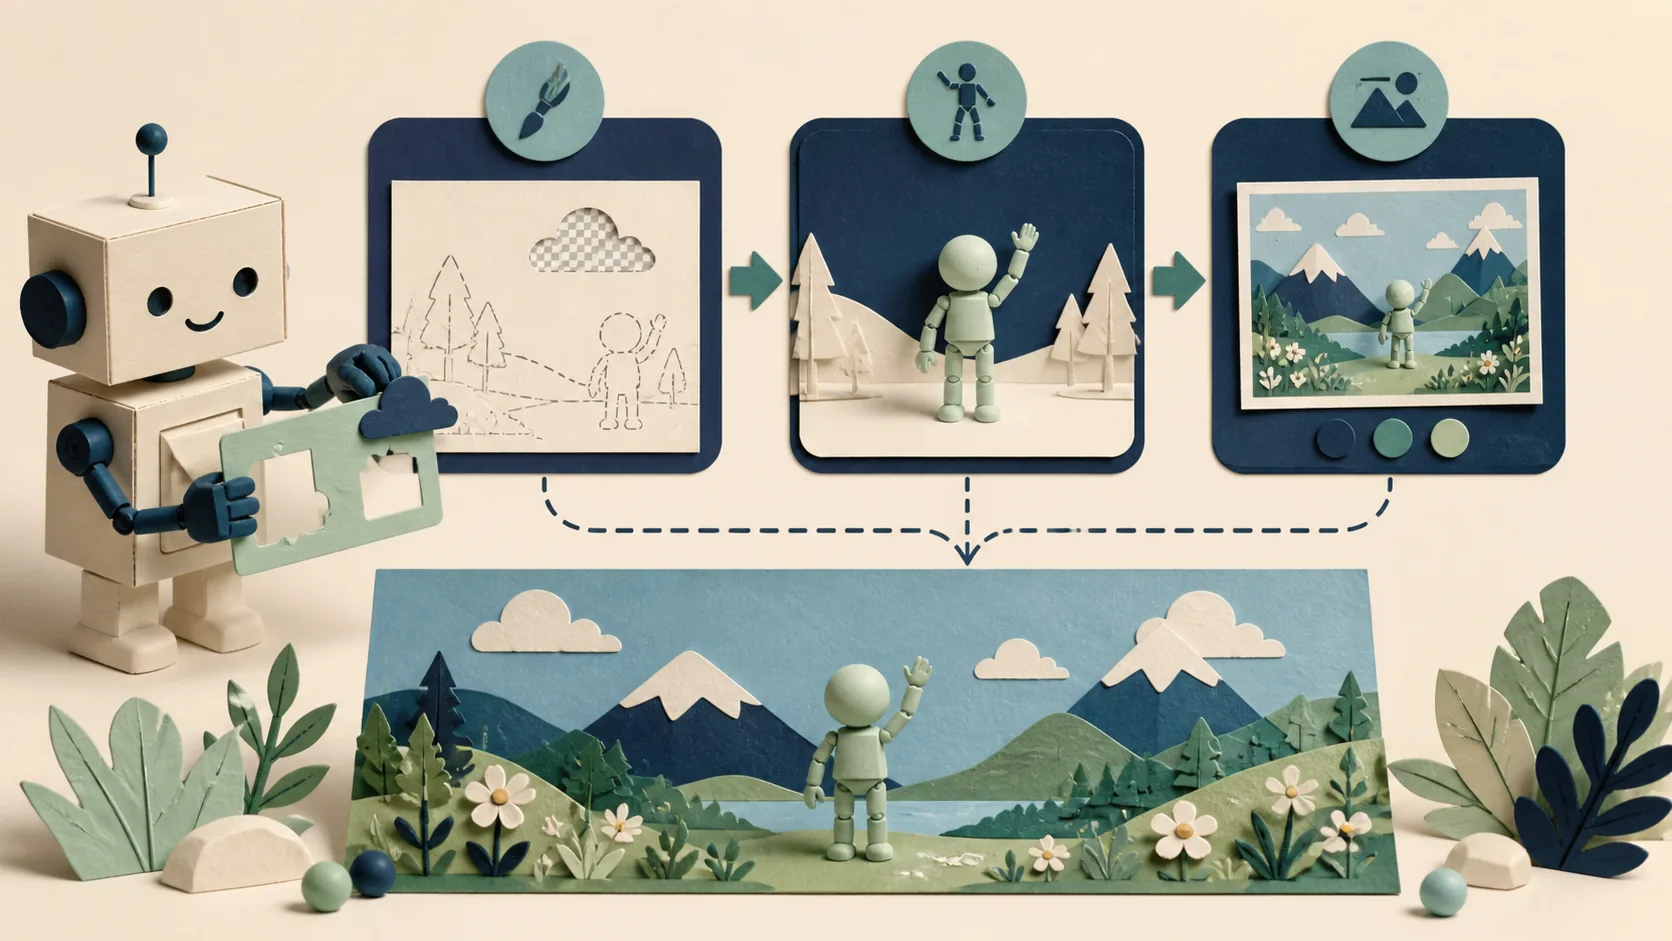 小机器人用模板、姿势和参考图控制画面 · 点击放大
 把任务卡和有限的笔记装进背包的小机器人 · 点击放大
 数字小角色在小片场里和声音节奏同步说话 · 点击放大
 不同工具通过统一插口连接到小机器人的工作台 · 点击放大
问题 01 / 10 · 约 2 分钟
你每天听到的 AI,到底是哪一种东西?
先说结论: 先分清公司、产品、模型和任务。它们常被一句“我们用了 AI”混在一起,比较之前必须先问对层级。
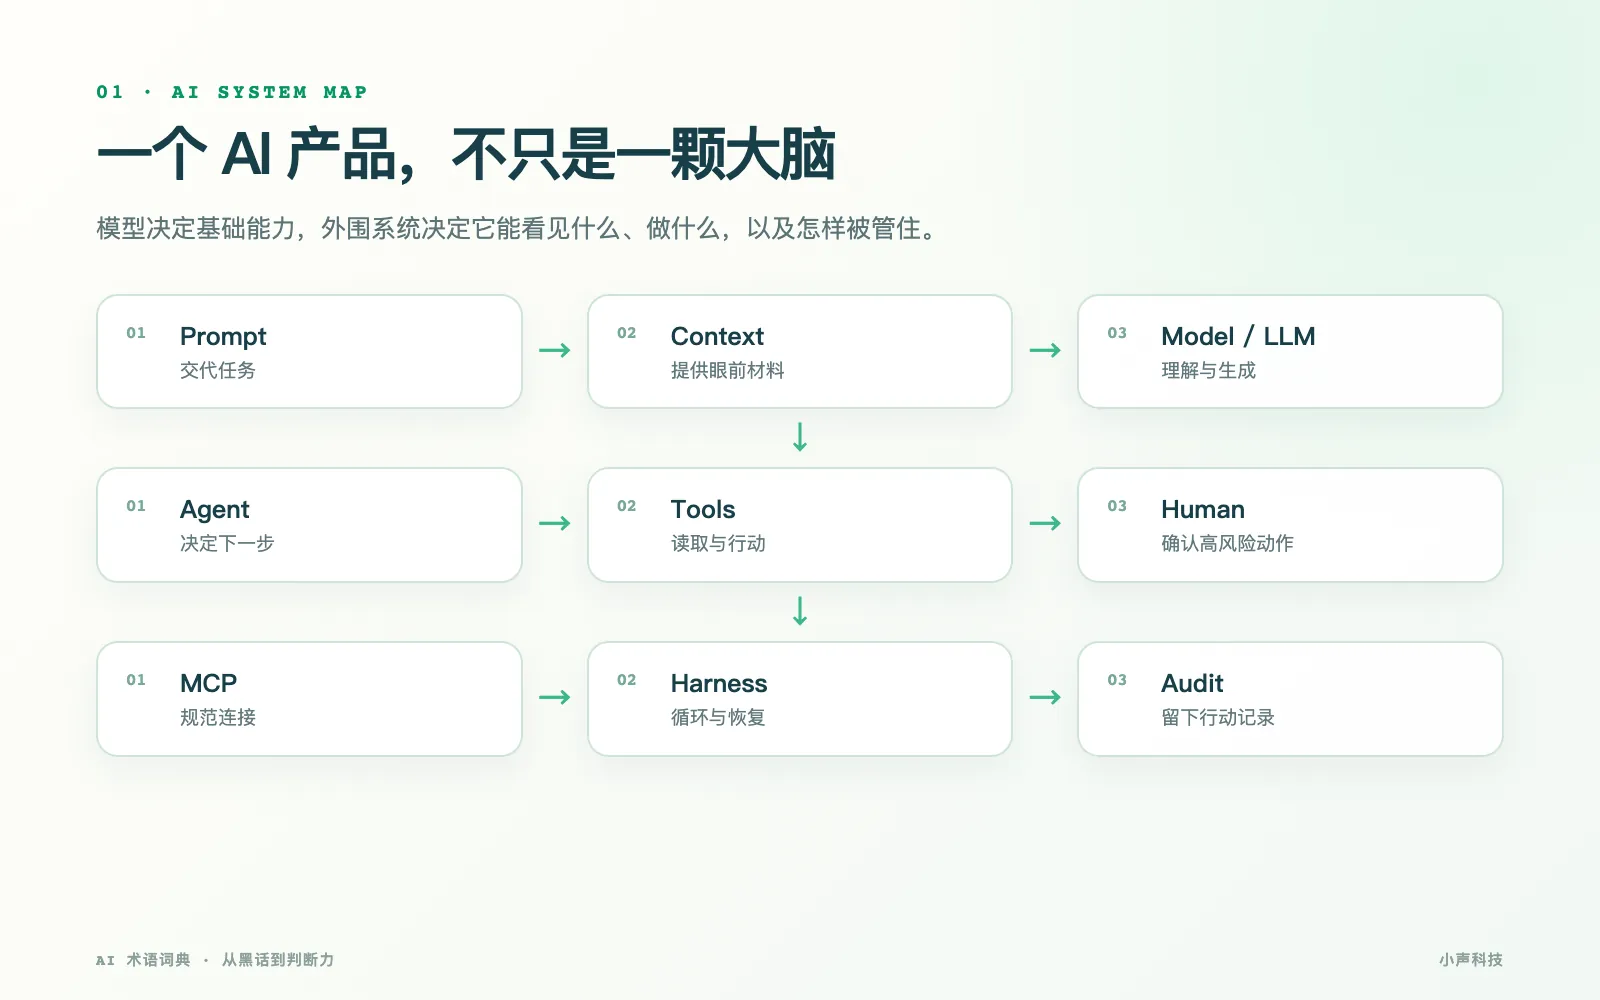 AI 产品由模型、上下文、工具、Agent、MCP、Harness 与人工确认组成的总地图 · 点击放大
同一天里,你可能听到三句话:“公司要做 AI”“我们换了更强的模型”“这个产品接入了 DeepSeek”。听起来都在说 AI,实际可能分别在谈公司战略、底层引擎和具体产品。
AI(Artificial Intelligence) 是最大的总称。地图预测堵车、相册认人、银行识别异常交易、聊天产品写邮件,都可以算 AI。Machine Learning(机器学习) 是实现 AI 的一类方法:不把每条规则写死,而是让系统从例子里找模式。训练后留下的计算引擎叫 Model(模型)。
当模型专门处理语言,我们常叫它 LLM(Large Language Model,大语言模型);能根据要求生产文字、图像、声音或视频,则属于 Generative AI(生成式 AI)。如果同一套系统还能同时处理文字、图片、音频等输入,产品会说自己支持 Multimodal(多模态)。
模型不是 App。ChatGPT、Claude、Gemini、DeepSeek 这些名字,有时指公司,有时指产品,有时指模型系列。真正比较时,要先问“你说的是哪一层”。一个产品体验变好,可能是模型升级,也可能只是检索、工具、界面和工作流变好了。
小实验:拆一句发布会口号
找一句“我们接入最先进 AI”的产品介绍,把它改写成四个问题:用了哪个模型?模型负责什么任务?接了哪些资料或工具?结果由谁复核?如果四个问题都答不上来,这句话提供的信息接近于零。
以后听到这些词,先问什么
- 它具体在生成、识别、预测,还是替人行动?
- 说的是公司、产品、模型,还是一个功能?
- 一次演示成功,能否代表长期稳定?
下一章: 模型能说出漂亮答案,不代表它在陈述事实。下一章看它为什么会一本正经地答错。
问题 02 / 10 · 约 3 分钟
它明明说得很像真的,为什么还是会胡说?
先说结论: 语言模型首先在生成合适的下一个 Token。流畅是它的本领,事实可靠需要上下文、资料、评测与核验共同完成。
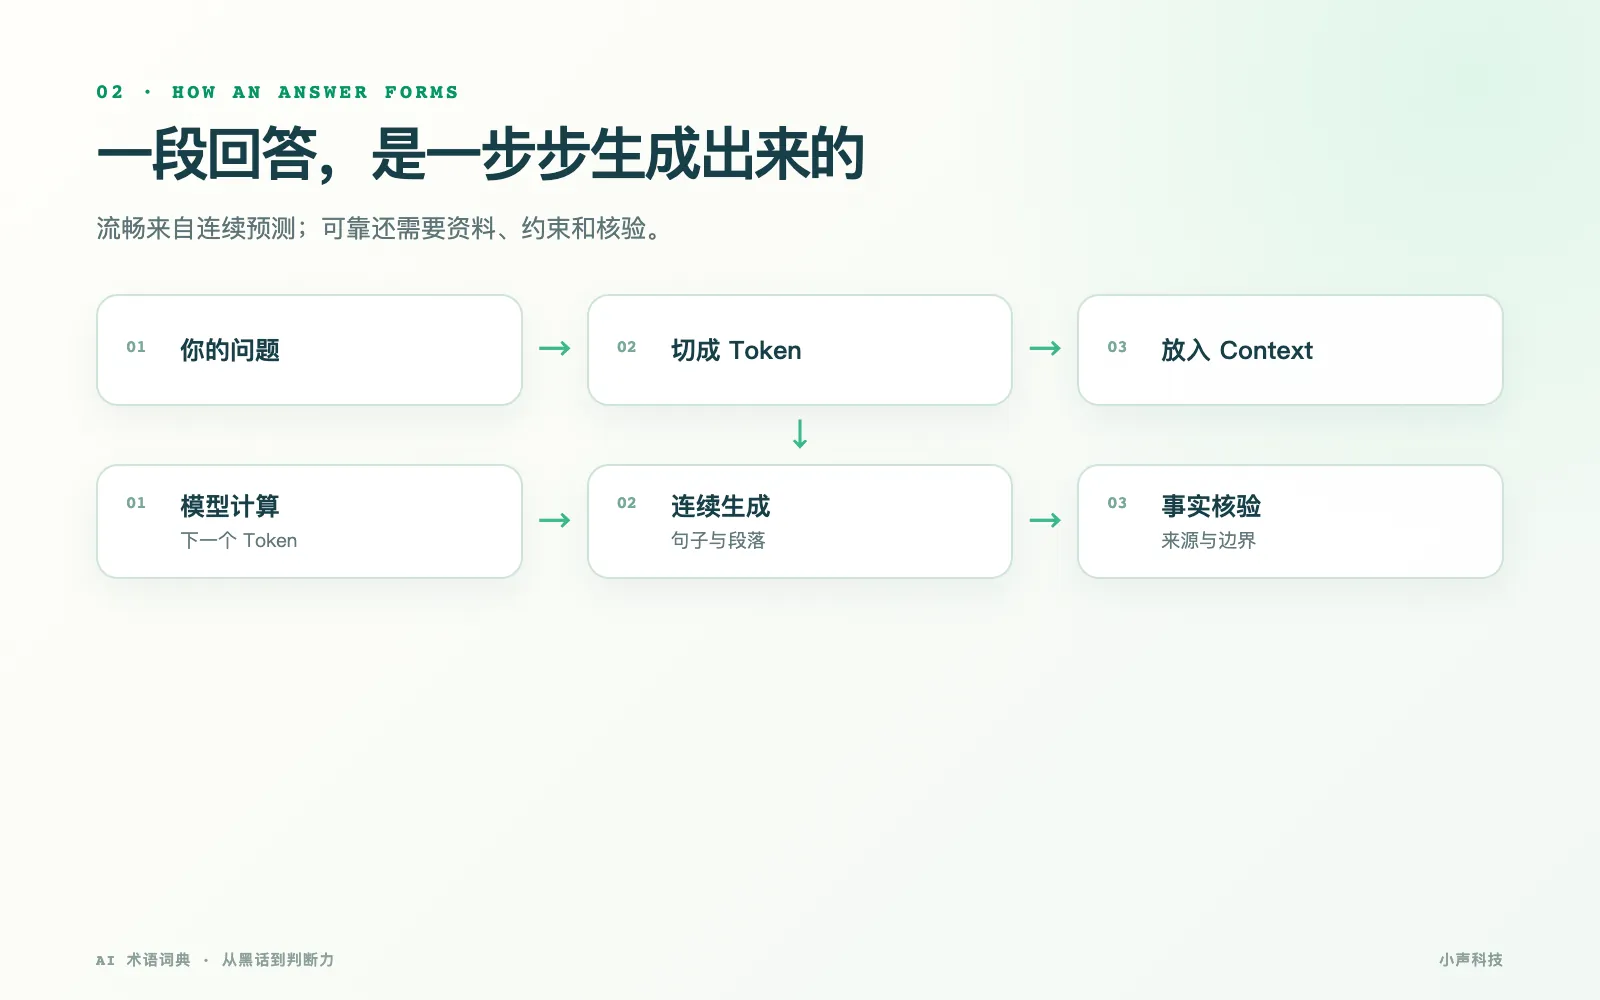 大语言模型从问题、Token、上下文到逐步生成与事实核验的过程图 · 点击放大
你让 AI 写一份行业简报,它把结构和术语写得像模像样,却混进一条不存在的数据。最危险的不是它答不上来,而是它答得太顺,让人忘了核验。
模型先把文字拆成 Token(词元),再根据这一轮能看见的全部内容,也就是 Context(上下文),计算接下来最合适的 Token。你给的任务叫 Prompt(提示词);产品在背后放入的角色、规则和安全要求常叫 System Prompt(系统提示词)。
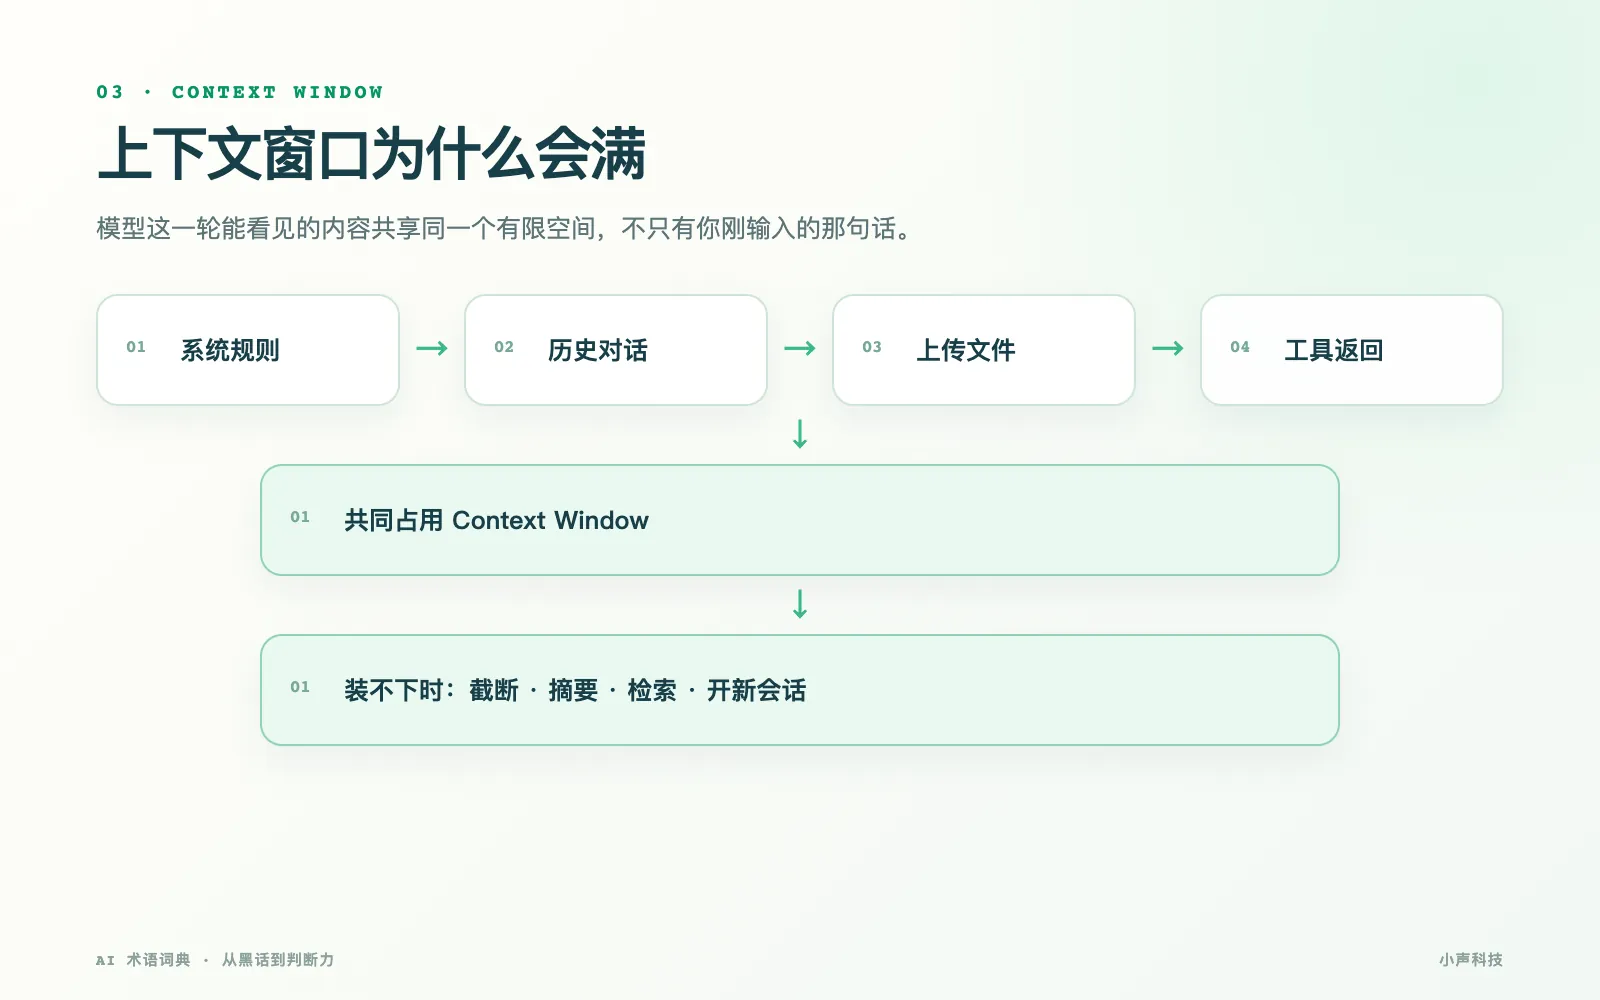 系统规则、历史对话、文件与工具结果共同占用上下文窗口的示意图 · 点击放大
上下文有容量上限,这就是 Context Window(上下文窗口)。它装的不只是一句话,还包括历史对话、上传文件、工具结果和系统规则。窗口很长,只说明放得下更多内容,不保证模型能在每个位置都稳定找到并正确理解。
模型在训练阶段从 Dataset(数据集) 学模式,内部由 Neural Network(神经网络) 和大量 Parameter(参数) 承载。今天的大语言模型大多使用 Transformer 架构。面对用户实际生成答案的阶段叫 Inference(推理或生成阶段);继续用特定数据调整行为叫 Fine-tuning(微调);用人类偏好反馈调整回答倾向,常见方法之一是 RLHF。
所谓 Reasoning(推理),可以让模型把复杂任务拆开处理,但不能自动把未知事实变成已知。没有依据却生成了听起来合理的内容,就是 Hallucination(幻觉)。
小实验:让它承认不知道
问 AI 一个你熟悉但公开资料很少的问题,要求它给出可打开的原始来源,并允许回答“不知道”。检查来源是否真的存在、是否支持那句话。不要只看链接长得像不像。
以后听到这些词,先问什么
- 它的答案来自给定资料、外部搜索,还是模型自己生成?
- 长上下文是容量宣传,还是在你的任务上做过检索测试?
- 所谓推理更强,提升的是解题能力还是事实可靠性?
下一章: 减少幻觉最直接的办法之一,是在回答前把相关资料找回来。下一章拆开 RAG。
问题 03 / 10 · 约 2 分钟
把 PDF 扔给 AI,它为什么还是会答错?
先说结论: 知识库不是上传按钮。可靠回答要经过分块、检索、放回上下文、基于依据生成和引用核验。
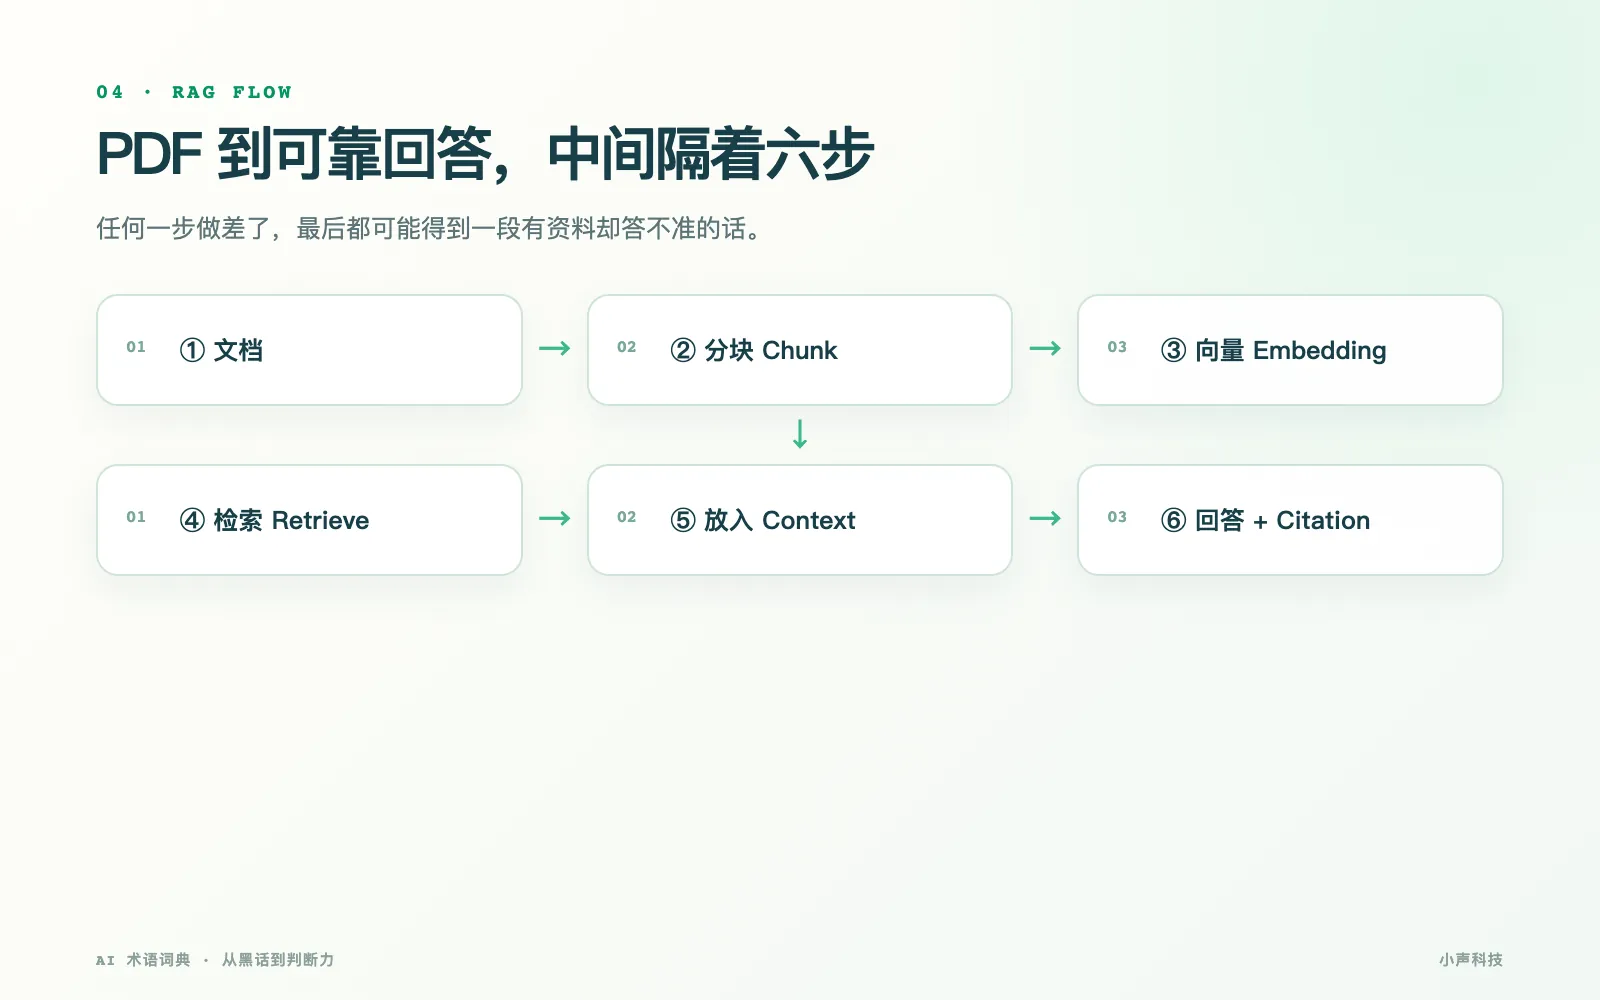 文档经过分块、向量化、检索、上下文与引用生成回答的 RAG 六步图 · 点击放大
假设公司把 86 页员工手册交给 AI,希望员工直接询问报销政策。第一次测试却发现:明明资料里写了,AI 还是答非所问。
系统通常先做 Chunking(分块),把长文切成能检索的小段;用 Metadata(元数据) 记录年份、部门、页码和适用地区;再把片段转换成 Embedding(嵌入向量),存进 Vector Database(向量数据库)。用户提问时,Semantic Search(语义搜索) 不只匹配字面相同的词,也寻找意思接近的片段。
把找回的片段放进上下文,让模型根据它们回答,就是 RAG(Retrieval-Augmented Generation,检索增强生成)。要求回答受资料约束叫 Grounding;把页码、原文链接或文档位置交给读者叫 Citation(引用)。
链路上任何一步做差都会出问题:切块把条件拆散了;旧政策没被过滤;搜索找到了“差旅”却错过“市内交通”;模型看到正确段落却忽略了例外条款。RAG 降低无依据生成的概率,不是事实保证。
小实验:问一个资料里没有的问题
上传一份带页码的短文档,先问一个原文明确回答的问题,再问一个文档里不存在的问题。可靠系统的差别,往往出现在第二问:它会明确说没有依据,还是继续拼出答案。
以后听到这些词,先问什么
- 原始资料能不能打开,还是只能看模型摘要?
- 资料什么时候更新,旧版本怎样下线?
- 找不到依据时,系统是否允许说不知道?
- 引用是否真的支持回答中的具体结论?
下一章: 有资料,AI 可以答得更可靠;有工具,它就不只会回答。下一章进入 Agent。
问题 04 / 10 · 约 3 分钟
它什么时候不只是聊天,而是真的开始替你干活?
先说结论: Agent 的分水岭不是说话像人,而是会围绕目标反复决定下一步、调用工具、观察结果并继续。
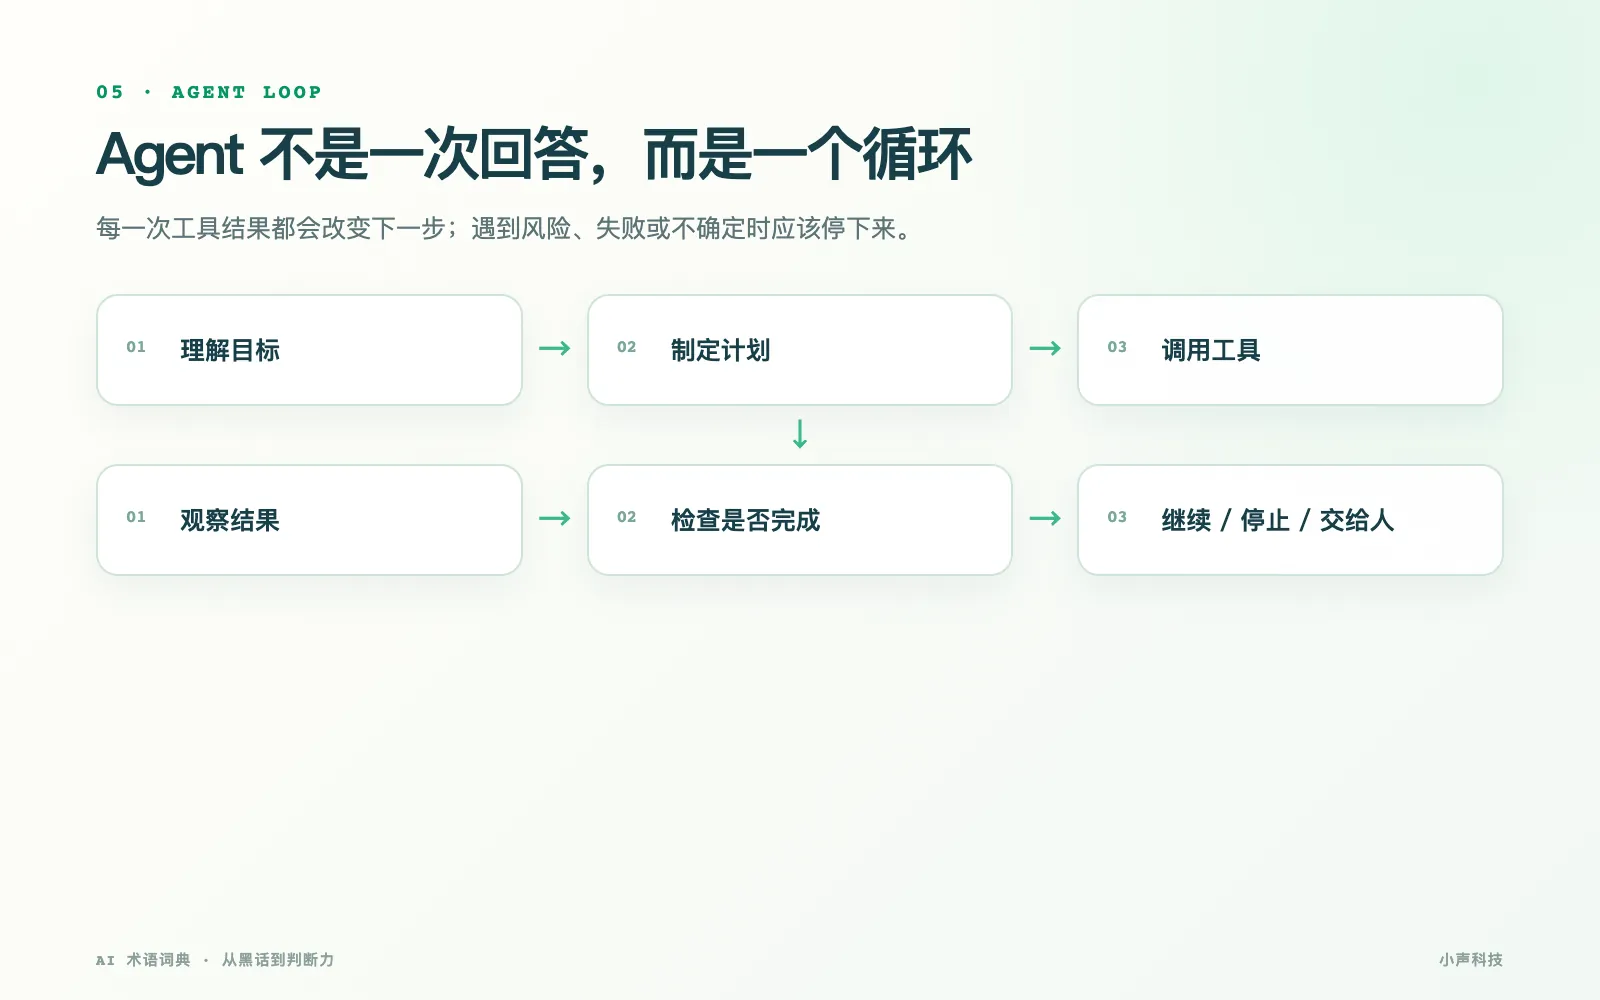 Agent 从理解目标、计划、调用工具到检查和交给人的循环图 · 点击放大
你让聊天机器人“整理本周竞品动态”,它可能给一套方法;让 Agent(智能体) 做同一件事,它可能搜索网页、读取文件、写成报告,再等待你确认发布。
模型通过 Tool Calling(工具调用) 或 Function Calling(函数调用) 请求外部能力。固定步骤适合 Workflow(工作流);任务不确定时,Agent 会做 Planning(规划),进入 Agent Loop(智能体循环):看当前状态、选择动作、读取结果、判断是否结束。可复用的任务说明和资源可以包装为 Skill(技能);多套 Agent 协作叫 Multi-Agent(多智能体),安排它们分工与顺序叫 Orchestration(编排)。
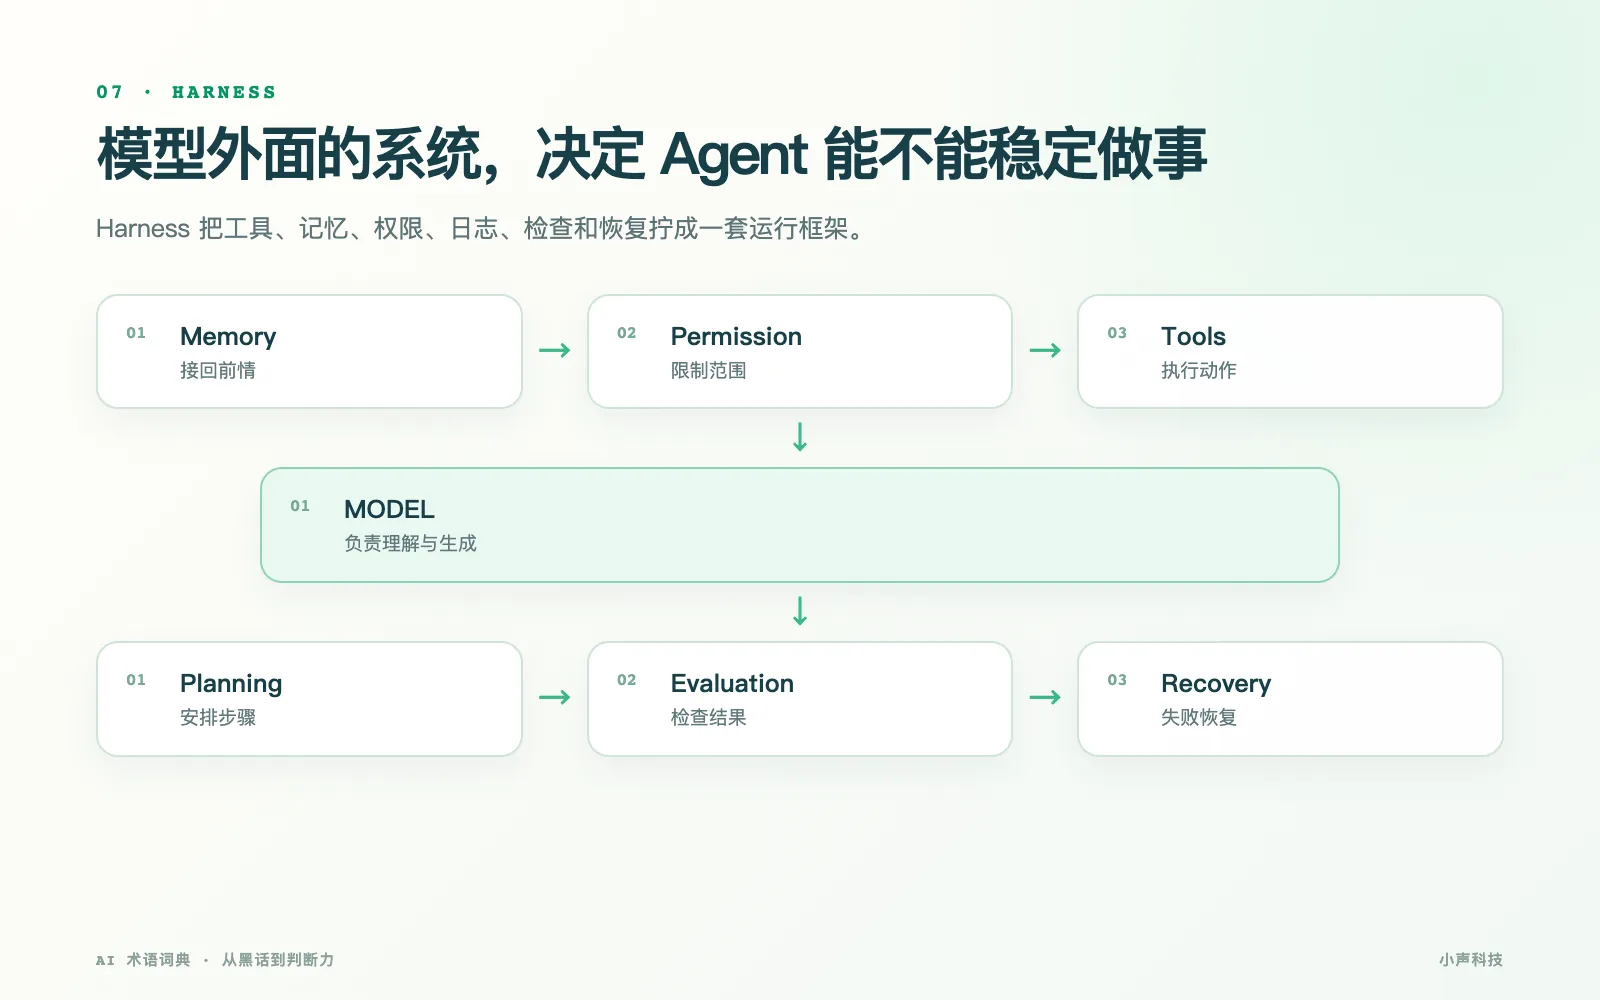 模型外的记忆、权限、工具、计划、评测与恢复组成 Harness 的分层图 · 点击放大
Agent 看起来突然“会做事”,通常不只是模型更聪明。Memory(记忆) 接回前情,Permission(权限) 划定范围,Human-in-the-loop(人在回路中) 把高风险决定交还给人,Harness(运行框架) 则把循环、工具、日志、检查和失败恢复拧在一起。
能力越强,失败方式越多。它可能选错工具、重复循环、在错误假设上继续工作,或收尾时声称完成但实际没有验收。因此“自主”不是取消人,而是重新安排人出现的位置。
小实验:把“帮我做”改成可验收任务
不要只说“帮我整理竞品”。改成:搜索哪些来源、覆盖哪段时间、输出什么字段、不得发布、找不到来源怎样标记、最后由我确认。观察任务边界清楚后,结果是否更容易检查。
以后听到这些词,先问什么
- 它能调用哪些工具,能读还是能改?
- 每一步有没有记录,结果怎样验收?
- 失败、卡住或理解错时,谁接手?
- 多 Agent 是否真的需要,还是增加了协调成本?
下一章: Agent 要连接文件、日历和数据库。MCP 解决接法,但接得上不代表有权使用。
问题 05 / 10 · 约 2 分钟
MCP 到底是什么,为什么大家都在提?
先说结论: MCP 统一的是 AI 连接工具与数据的方式,不是模型能力升级,也不会自动解决权限。
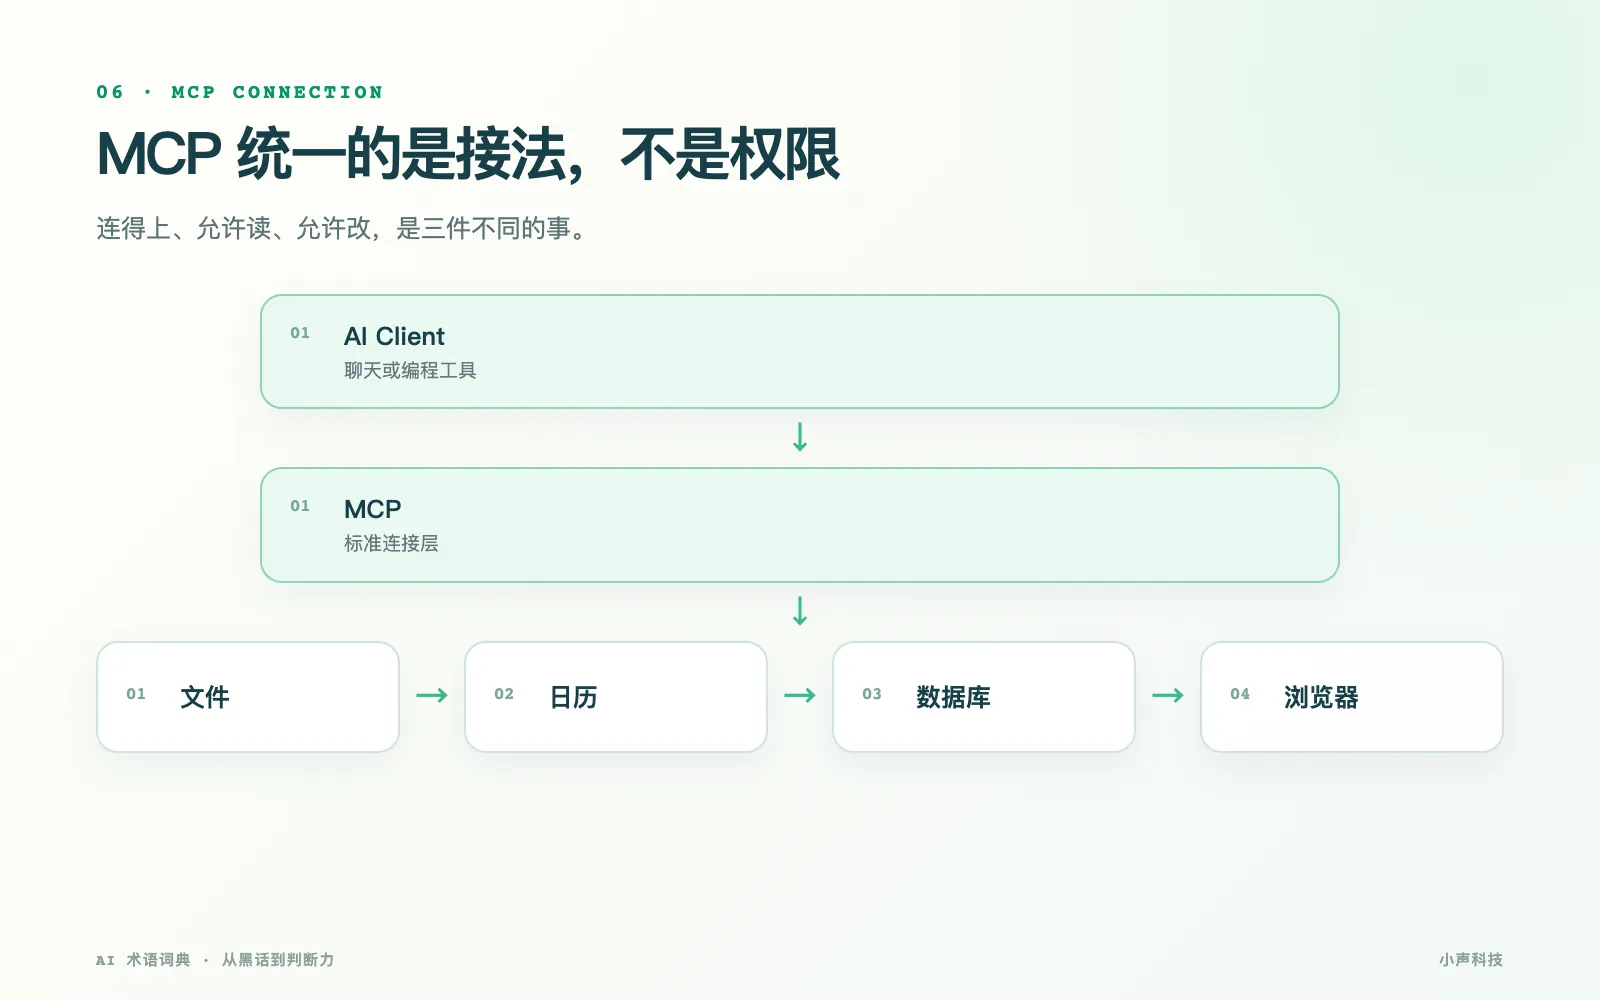 AI 客户端通过 MCP 连接文件、日历、数据库和浏览器的插座图 · 点击放大
同一个 AI 要读取文件、查看日历、查数据库和访问网页,过去每种连接可能都要单独适配。MCP(Model Context Protocol) 提供一套更统一的协议,让客户端发现服务器提供的资源、提示模板和工具。
运行这些能力的一端叫 MCP Server,使用它们的聊天或编程产品可看作客户端。服务器可以暴露可读取的 Resources、可执行的 Tools 和预设 Prompts。它像统一插座,但不会替你判断这台电器是否该接,也不会自动限制它能碰到的文件。
更通用的软件办事窗口叫 API。API 解决软件之间怎样请求服务;MCP 更贴近 AI 客户端怎样发现和调用上下文与工具。两者可能同时存在,MCP Server 背后也可能调用多个 API。
真正的边界仍在权限:能发现某个工具,不等于被允许执行;允许读取日历,不等于允许创建或删除日程。协议让连接更规范,授权、确认和日志仍然要由产品与组织设计。
小实验:安装前先读能力清单
看到一个 MCP Server,不要先点安装。先写出三列:它要读取什么、能修改什么、会把数据发到哪里。任何一列答不出来,都不该直接交给工作账号。
以后听到这些词,先问什么
- 连接的是哪个服务器,谁维护?
- 它提供 Resources、Prompts 还是 Tools?
- 哪些操作由用户触发,哪些可由模型触发?
- 数据是否会离开本机或组织边界?
下一章: 连接好工具后,AI 最常见的实际工作之一是改代码。下一章看“写好了”为什么只是中间状态。
问题 06 / 10 · 约 2 分钟
AI 写代码,到底帮谁做了什么?
先说结论: AI 编程的价值不只在生成代码,而在理解代码库、修改、运行、测试、审查和回退的完整闭环。
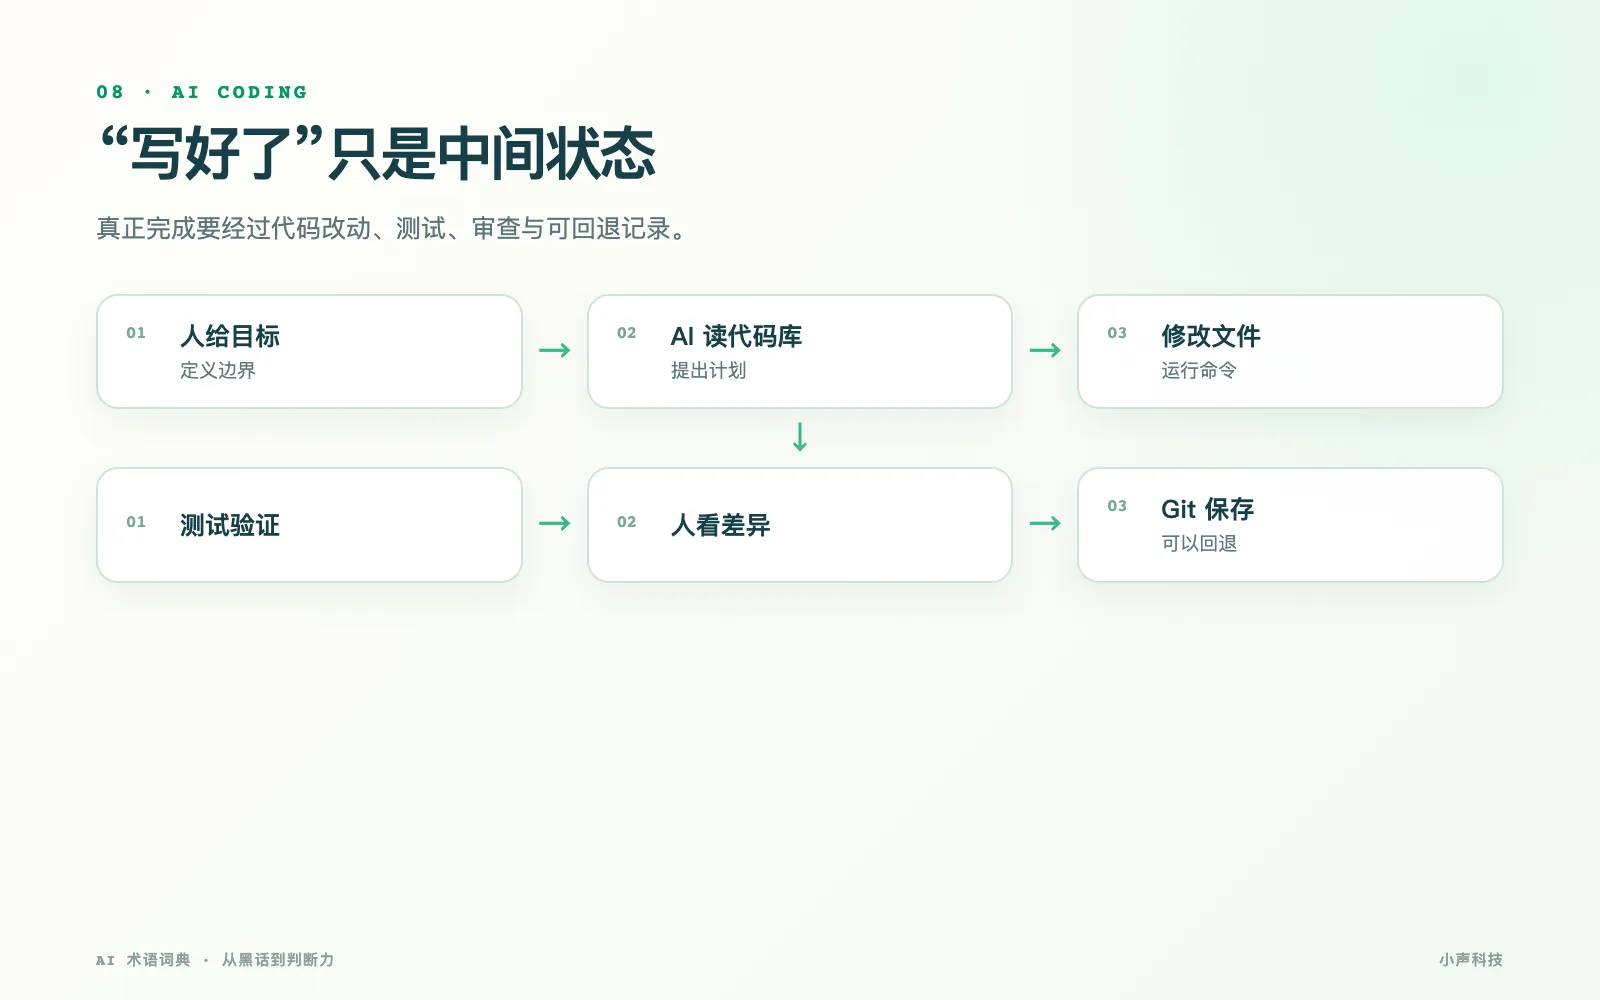 人、AI、代码库、命令、测试和 Git 共同完成 AI 编程的协作图 · 点击放大
有人说“一句话生成 App”,也有人说“AI 写的代码根本不能用”。两句话都可能包含真实部分。区别在于任务大小、已有代码、工具权限、测试和最后有没有人对结果负责。
在 IDE(集成开发环境) 里,AI 可以补全、解释和修改代码;通过 CLI(命令行界面),它还能运行构建、测试和脚本。AI Coding(AI 编程) 逐渐从“替你写几行”变成 Agent 读取代码库、制定计划、修改多个文件并检查结果。
Sandbox(沙箱) 把执行限制在隔离环境;Git(版本控制) 记录改动,让人比较差异并回退;Eval(评测) 和自动测试验证功能是否真的满足要求。没有这些环节,“完成”往往只代表模型停止生成。
不会编程的人也能受益,但更需要把验收写清:页面能打开不等于数据安全,按钮能点击不等于异常情况处理正确。高风险系统不能只靠“看起来能跑”。
小实验:只让 AI 做一项可验证改动
选择一个已有小项目,让 AI 改一句文案或增加一个字段。要求它先列计划、完成后给出修改文件、运行的测试和回退方式。观察它的收尾是否有证据,而不是只有“已完成”。
以后听到这些词,先问什么
- 改了哪些文件,为什么改?
- 构建和测试是否真的运行,结果是什么?
- 它能否碰生产数据、密钥和工作区外文件?
- 出错后有没有可恢复版本?
下一章: 代码可以测试,生成图像和视频却没有一条统一的“通过”标准。下一章看创作控制。
问题 07 / 10 · 约 3 分钟
一句话变成图和视频,中间到底发生了什么?
先说结论: 生成内容不是提示词直接变成成品,而是生成、约束、筛选和局部修改的连续过程。越追求一致性,越需要参考与人工控制。
你写一句提示词,第一次人物很好,第二次脸和衣服却变了;视频第一秒漂亮,十秒后手、口型和镜头开始漂。生成内容最迷人的地方,也是最需要人盯住的地方。
Diffusion Model(扩散模型) 可以粗略理解为从噪声中逐步整理出图像。Text-to-Image(文生图) 从文字开始,Image-to-Image(图生图) 则让已有图像参与控制。固定 Seed(种子) 有助于复现相近起点;LoRA 可以用较小训练成本学习某类角色或风格。
想局部修改用 Inpainting(局部重绘),向外扩展画面用 Outpainting(扩图);Reference Image(参考图) 告诉模型构图、人物或气氛方向;ControlNet 等控制方法用姿势、线稿或深度信息把画面约束得更具体。
声音侧,ASR 把语音转文字,TTS 把文字变成语音。Video Generation(视频生成) 还要维持时间连续性;Avatar(数字形象) 与 Lip Sync(口型同步) 可以制作讲解者,但涉及真人身份时会进入 Deepfake(深度伪造) 风险。
参考图不是授权书,口型对上也不证明真人说过。生成能力越强,Copyright(版权)、Disclosure(AI 内容披露) 与来源记录越重要。
小实验:用控制变量改一张图
固定同一个提示词和参考图,每次只改一个变量:构图、光线、比例或局部区域。比较结果。你会发现“提示词越长越好”并不成立,可控来自明确变量和迭代记录。
以后听到这些词,先问什么
- 用了哪些参考材料,是否有授权?
- 哪些部分是生成、局部修改或真人素材?
- 人物身份、声音和口型会不会让人误认?
- 发布时是否需要明确披露 AI 参与?
下一章: 生成内容会误导,Agent 还会真的行动。下一章把权限、安全和责任放到同一张图上。
问题 08 / 10 · 约 2 分钟
为什么越能干的 AI,越不能让它随便干?
先说结论: 安全不是最后加一句提醒,而是从一开始决定 AI 能看什么、能做什么、何时必须停下来问人。
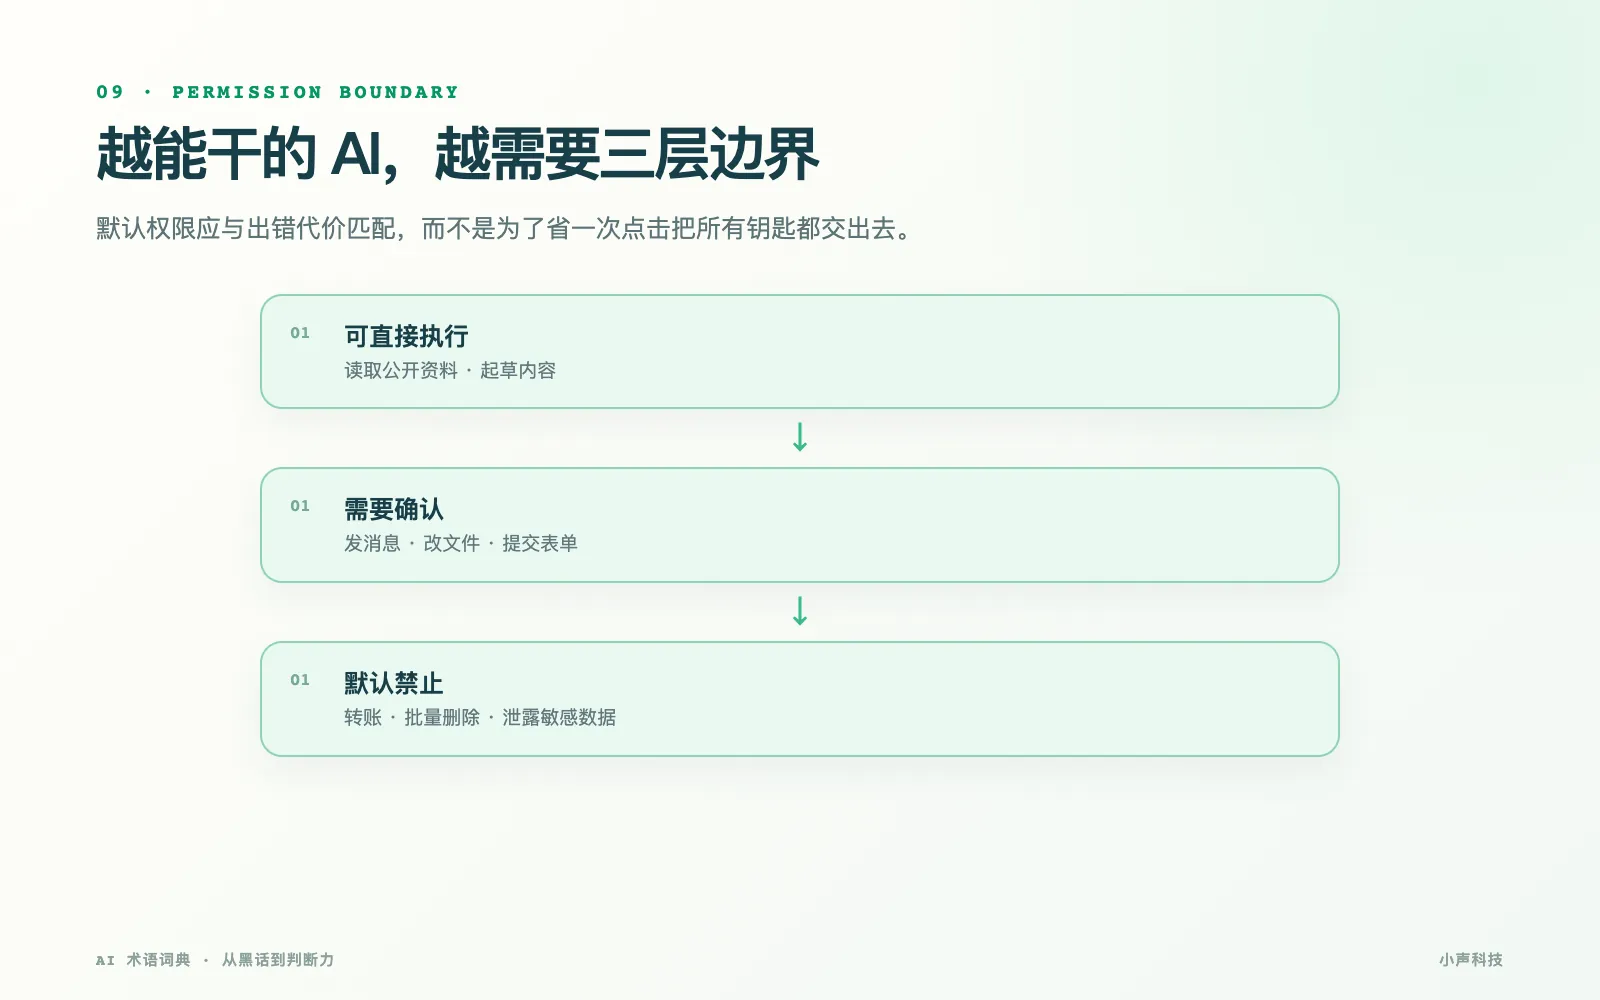 AI 动作分为可直接执行、需要确认和默认禁止的三层权限边界图 · 点击放大
让 AI 总结公开文章,和让它批量修改客户文件、发邮件、删除资料,表面都叫“帮忙”,出错代价却完全不同。
外部网页或文件里可能藏着诱导 AI 改变任务的指令,这叫 Prompt Injection(提示注入);用户试图绕过产品限制叫 Jailbreak(越狱)。一句“不要被骗”挡不住它们,需要多层 Guardrails(护栏)。
Least Privilege(最小权限) 要求只给当前任务刚够用的钥匙;PII 提醒我们姓名、联系方式、账号和图像可能识别具体个人;Audit Log(审计日志) 记录谁发起任务、模型调用什么工具、谁确认了动作。
风险不是只看发生概率,还要看后果。读公开网页答错一句和批量转账错一次,不能用同一审批规则。可靠的系统会把可逆、低风险动作自动化,把外发、删除、支付和敏感数据操作交还给人。
小实验:给一个自动化任务画权限表
选“整理邮箱”或“整理文件”任务,分三列写:可直接做、必须确认、默认禁止。再检查 AI 实际得到的权限是否比任务需要更多。
以后听到这些词,先问什么
- 最坏会改掉、发出或泄露什么?
- 哪些动作不可逆,是否二次确认?
- 是否保存敏感数据,多久删除?
- 出了事能不能还原完整过程?
下一章: 安全边界确定后,产品还要在质量、速度和成本之间做选择。下一章看这笔账。
问题 09 / 10 · 约 2 分钟
同一个 AI,为什么有时很快、有时很慢、有时很贵?
先说结论: 速度、质量和成本很少同时拉满;先固定任务与验收,再比较模型和产品。
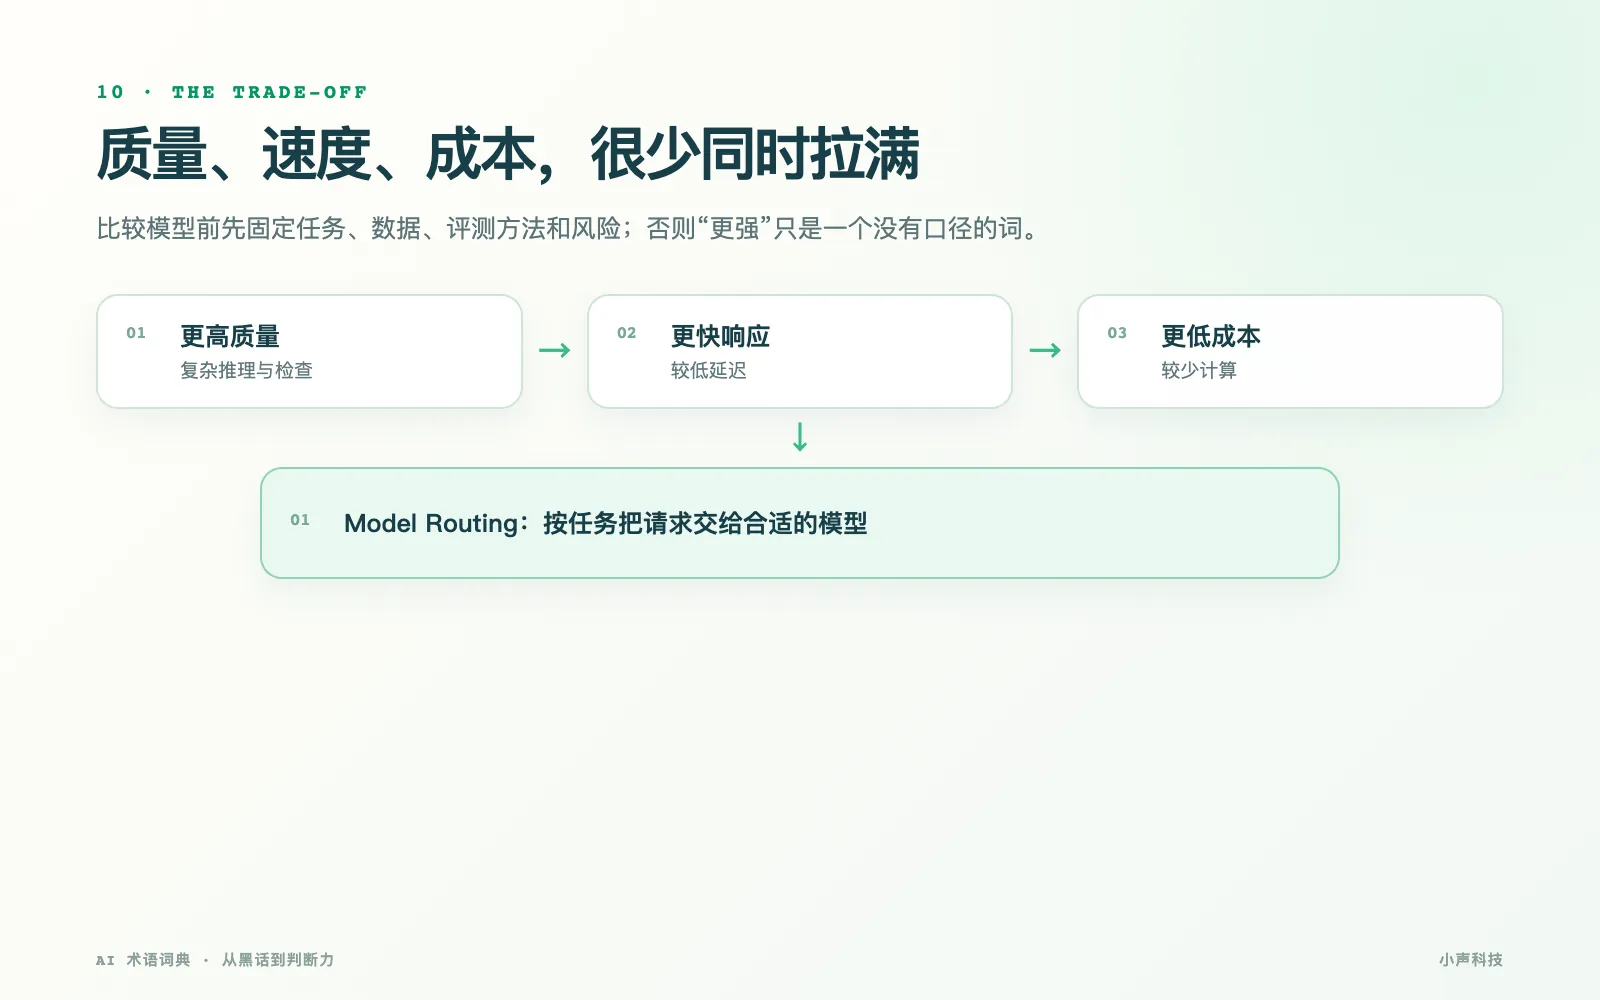 AI 系统在质量、速度和成本之间取舍并通过模型路由分配任务的三角图 · 点击放大
同一个问题,上午几秒答完,下午却等很久;同一产品有时免费,有时提示额度用完。读者需要理解的不是某个会过期的价格,而是体验背后的交换。
Latency(延迟) 关心一项请求要等多久,Throughput(吞吐量) 关心系统一段时间能处理多少任务。Cache(缓存) 保存重复使用的前缀、资料或结果,可以更快、更便宜。Model Routing(模型路由) 则把简单任务交给快而便宜的模型,把复杂或高风险任务交给更强模型。
比较模型常用 Benchmark(基准测试),但排行榜像考试:高分只证明擅长那套题。真正部署还要做贴近场景的 Eval,区分 Capability(能力) 和 Reliability(可靠性)。偶尔做到是能力,换个说法、连续运行、遇到异常仍然可用,才接近可靠。
模型语气坚定也不代表正确。Confidence(置信度) 只有经过校准,才可能对应真实命中率。最终比较要把失败代价算进去,而不只是平均分和单次速度。
小实验:用同一任务比较两个模型
固定输入、输出格式和检查标准,各运行三次。记录首字等待、总时间、事实错误、遗漏和人工修改时间。最后比较“完成一件可用结果”的总成本,而不只看一次回答价格。
以后听到这些词,先问什么
- 评测题是否贴近我的真实任务?
- 展示的是最好一次、平均表现还是最差风险?
- 价格包含输入、输出、检索和工具调用吗?
- 更快更便宜,牺牲了什么?
下一章: 最后一章不再追具体排行榜,而是建立一套面对任何新名词都能使用的判断方法。
问题 10 / 10 · 约 2 分钟
看到一个新 AI 名词时,到底该怎么判断?
先说结论: 先定位它属于哪一层,再找评测、用途、限制、来源和责任。新名字不等于新能力,公开也不等于完整开源。
一个产品说自己“全自主、零幻觉、完全开源”,三句话都需要拆口径。
先找 Model Card(模型说明卡):它应该交代预期用途、评测条件、限制和不适用场景。再看 Benchmark 测了什么、是否能复核。不要把 Capability 当 Reliability,也不要把一次演示当长期表现。
“开源”也要拆。Open Weight(开放权重) 表示能取得训练后参数,训练代码、数据说明和许可未必完整开放。Open Source AI(开源 AI) 还涉及使用、研究、修改、分享所需的代码、参数和数据信息。具体能否商用,仍要看许可证。
数据层看 Data Provenance(数据来源链):资料从哪里来,怎样获得,经过什么处理,是否允许当前用途。模型可能出现 Sycophancy(迎合性),因为用户暗示而附和错误观点;训练数据被低质量生成内容反复污染,还可能面临 Model Collapse(模型坍塌) 风险。
最终不要问“它是不是 AI”,而要问:它解决哪件事?证据是什么?在什么条件下失败?谁受到影响?出了错由谁发现、修复和承担。NIST 的 AI 风险管理思路可以浓缩成四个动作:治理、识别场景、测量风险、采取管理措施。
小实验:拆一条“革命性”宣传
找一条新产品宣传,把每个形容词改成可验证问题。“更强”改成在哪套任务上强;“自主”改成能调用哪些工具;“安全”改成有哪些权限、评测和事故记录;“开源”改成开放了权重、代码、数据说明还是全部。
以后听到这些词,先问什么
- 它是模型、产品、工具、协议,还是营销名称?
- 证据来自官方自测、第三方评测还是单次演示?
- 适用和不适用场景写清了吗?
- 数据、权限、成本和失败责任由谁承担?
- 这条信息是否带版本和日期?
下一章: 你不需要追完所有新词。能稳定问出这些问题,已经从认识黑话走到了拥有判断。
写在开始之前
给非技术读者的第一册
版本:0.5 · 2026 年 11 月
阅读方式:先按问题读,再按术语查。
给微信读书读者的话
如果你是在微信读书里打开这本书,先放下一个负担:你不需要先懂技术。第一遍顺着十个问题读,遇到卡住的词再查;第二遍再把它当工具箱,在搜索框里输入中文、英文或缩写。
书里保留英文原词,不是为了显得专业。产品菜单、发布会和同事聊天常常只写 context、token、agent 或 MCP。看懂中文以后,你还得能认出它们在真实世界里的名字。
AI 变得很快,所以这本书不承诺一张永不过期的产品名单。它留下的是几句更耐用的问题:这是什么层?解决什么问题?它看到了什么?能做什么?错了怎样发现?最后由谁负责?
本轮于 2026 年 11 月 7 日复核协议与模型相关说明。基础术语保留,新增“版本、能力和权限分开核对”的方法;旧产品举例不作为当前购买或接入清单。
这本书怎样读
正文是一条问题路线,不按术语顺序上课。十章各自抓住一个真实场景,先给判断,再拆机制、误解和代价。每章都有一项不需要编程的小实验,以及一组“下一句该问什么”。
书末是独立术语索引。网站读者可以搜索,电子书读者可以用目录或全文检索跳转。正文里的术语不编号,内部链接仍保持稳定。
结语:把术语变成判断力
如果只记住六句话,就记住这些:
- 模型是能力引擎,不是完整产品。
- 上下文不是记忆,生成不是事实。
- RAG 帮模型找到依据,不替你保证依据正确。
- Agent 能行动,Harness 决定它怎样行动,MCP 规范它怎样连接。
- 能力不等于可靠,排行榜不等于你的真实任务。
- 越接近真实行动,越要把权限、日志、确认和责任写清。
下一次听到新名词,不必急着记。先问它属于哪一层、解决什么问题、拿什么做证据、出错会怎样。能问出这几句,黑话就很难再牵着你走。
附录:判断工具箱
容易混淆的十组词
| 不要混为一谈 | 最短区别 |
|---|---|
| Model / Product | 模型是能力引擎,产品是模型加界面、资料、工具和规则 |
| Prompt / Context | Prompt 是任务表达,Context 是这一轮模型能看见的全部内容 |
| Context / Memory | Context 是眼前内容,Memory 是被保存后可能再次取回的信息 |
| RAG / Fine-tuning | RAG 临时找资料,Fine-tuning 调整模型长期行为倾向 |
| Workflow / Agent | Workflow 主要按预定步骤走,Agent 会根据结果决定下一步 |
| Agent / Harness | Agent 推进任务,Harness 提供运行、权限、检查与恢复框架 |
| MCP / API | API 是通用软件接口,MCP 面向 AI 工具与上下文接入 |
| Open Weight / Open Source AI | 有权重不代表代码、数据说明和许可都完整开放 |
| Capability / Reliability | 能偶尔做到是能力,能持续做到才接近可靠 |
| Inpainting / Outpainting | 一个改图内局部,一个向图外扩展 |
任何新名词都能用的六问
- 它属于模型、产品、工具、协议还是安全控制?
- 它具体解决什么问题?
- 证据来自哪种评测,能否复核?
- 它能访问哪些数据、调用哪些工具?
- 最常见和代价最大的失败是什么?
- 谁确认、记录、修复并承担责任?
术语速览
Agent Loop · Agent · AI Coding · AI · Algorithm · API · ASR · Audit Log · Avatar · Benchmark · Cache · Capability · Chunking · Citation · CLI · Confidence · Context Window · ControlNet · Copyright · Data Provenance · Dataset · Deepfake · Diffusion Model · Disclosure · Embedding · Eval · Fine-tuning · Function Calling · Generative AI · Git · Grounding · Guardrails · Hallucination · Harness · Human-in-the-loop · IDE · Inference · Inpainting · Jailbreak · Latency · Least Privilege · Lip Sync · LLM · LoRA · Machine Learning · MCP Server · MCP · Memory · Metadata · Model Card · Model Collapse · Model Routing · Model · Multi-Agent · Multimodal · Neural Network · Open Source AI · Open Weight · Orchestration · Outpainting · Parameter · Permission · PII · Planning · Prompt Injection · Prompt · RAG · Reasoning · Reference Image · Reliability · RLHF · Sandbox · Semantic Search · Skill · Sycophancy · System Prompt · Text-to-Image · Throughput · Token · Tool Calling · Training · Transformer · TTS · Vector Database · Video Generation · Workflow
标成学完,学习目录里会打勾。以后遇到新词,回到上面的索引查。
本词典由小声工作室编写,原文:www.ssgoo.net/ai-glossary。